“Nell’era dell’intelligenza artificiale generativa e dell’interazione in tempo reale abilitata da Gemini 3.8 Live, il nostro paradigma di business deve subire una metamorfosi radicale. La visibilità non si conquista più rincorrendo vecchi algoritmi o cercando di assecondare le macchine con tecniche obsolete, ma strutturando la propria esperienza in asset intangibili inattaccabili. Non dobbiamo limitarci a sperare di essere intercettati: dobbiamo costruire un ecosistema di verità, empatia e autorevolezza aziendale così solido e identitario da renderci l’unica fonte possibile per il nostro mercato. La vera innovazione non è una sterile rincorsa all’ultimo aggiornamento software, ma una raffinata ingegneria cognitiva – proprio come quella che guida l’evoluzione conversazionale di Gemini 3.8 Live – applicata alla vita reale delle imprese. È qui che la tecnologia smette di essere un ostacolo e diventa il partner strategico definitivo per esaltare il fattore umano, generando valore concreto e sostenibile nel tempo.”
— Massimo Rossetti, Innovation Manager Certificato UNI 11814
Il primo assistente vocale che ho provato, nel 2016, impiegava quattro secondi per dirmi che non aveva capito la domanda. Quattro secondi di silenzio, poi una voce metallica che chiedeva di ripetere. Oggi quel ritardo sembra preistoria.
Gemini 3.8 Live elabora una risposta mentre la persona sta ancora finendo di parlare, con una latenza ridotta a una frazione di secondo. La differenza non è solo tecnica: è percettiva.
La novità annunciata da Google non riguarda un semplice aggiornamento di velocità. Il sistema integra capacità di elaborazione del linguaggio naturale avanzate, ottimizzate per conversazioni in tempo reale. In pratica, l’IA non aspetta che l’utente smetta di parlare per iniziare a pensare.
Analizza il flusso del discorso, anticipa il senso della frase e prepara la risposta mentre le parole arrivano ancora al microfono. Questo cambia la natura stessa del dialogo con una macchina.
Per chi usa assistenti vocali ogni giorno, il beneficio è immediato. Niente più pause imbarazzanti. Niente più comandi spezzettati in frasi rigide.
Si parla con un ritmo naturale, come si farebbe con una persona. E il sistema risponde con la stessa fluidità.
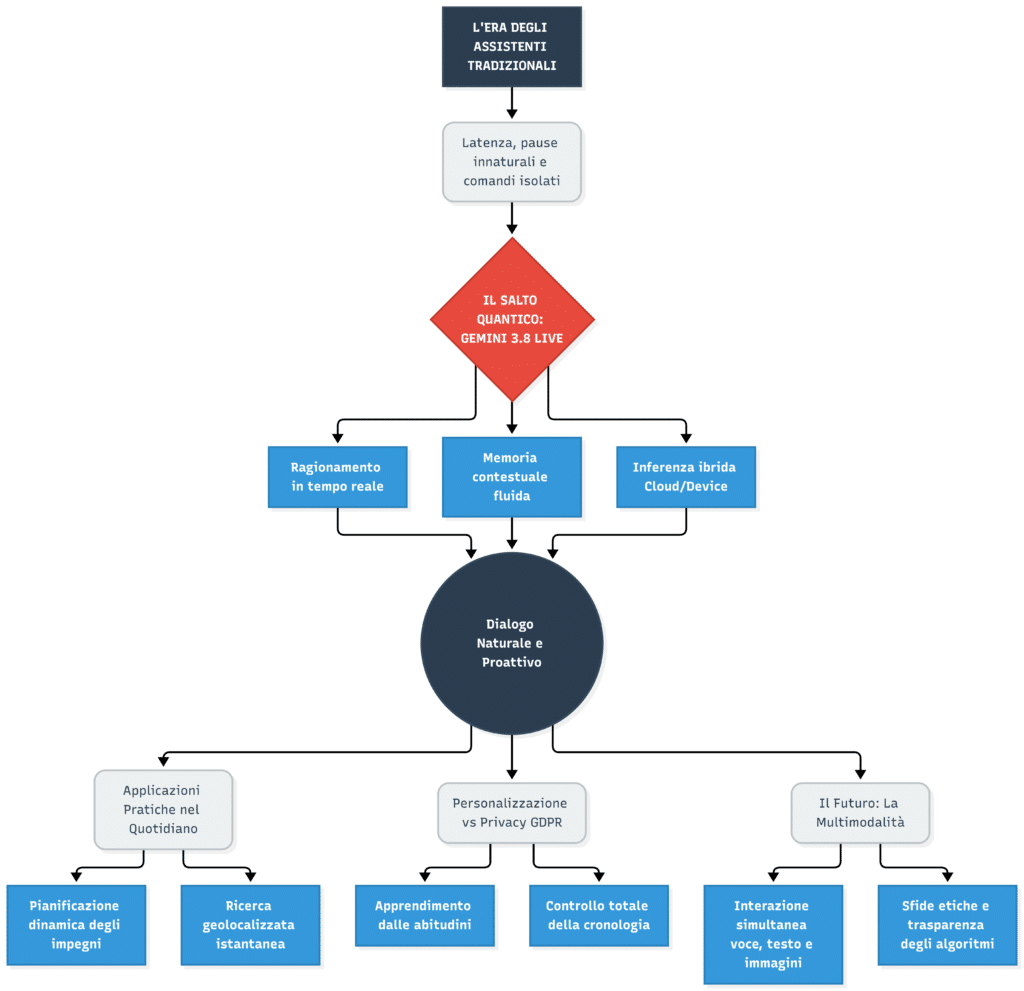
L’articolo esplora cosa rende possibile questo salto. Si parte dal funzionamento interno: modelli predittivi, reti neurali, gestione del contesto e dell’intento. Poi si passa all’uso pratico nella quotidianità italiana, dalla pianificazione della giornata alla ricerca di informazioni locali.
Si affronta anche il tema della personalizzazione e della privacy, due facce della stessa medaglia. Infine, uno sguardo al futuro: multimodalità, sfide etiche e opportunità di crescita per un’interazione vocale che smette di essere un comando e diventa conversazione.
- Come funziona il ragionamento in tempo reale di Gemini 3.8 Live
- Perché la latenza ridotta trasforma l’esperienza d’uso
- Applicazioni concrete per la vita quotidiana in Italia
- Personalizzazione, privacy e scenari futuri
Non è solo un assistente più veloce. È un modo diverso di pensare il dialogo uomo-macchina, dove la macchina smette di essere un esecutore passivo e diventa un interlocutore attivo. Per gli utenti italiani, abituati a interfacce vocali spesso rigide e poco reattive, il salto è tangibile. E merita di essere capito a fondo.
Gemini 3.8 Live rappresenta il tentativo più ambizioso di Google di trasformare un assistente vocale in un interlocutore capace di elaborare le informazioni mentre la conversazione è ancora in corso, senza le pause che in passato rendevano ogni scambio innaturale. La differenza sostanziale rispetto alle versioni precedenti non sta nella velocità di risposta, ma nella capacità di costruire un ragionamento articolato in tempo reale, adattandosi alle interruzioni e ai cambi di direzione dell’utente. Per chi in Italia ha sempre percepito gli assistenti vocali come strumenti rigidi e prevedibili, questa evoluzione promette interazioni finalmente simili a un dialogo tra persone.


Dall’Assistente vocale al ragionamento intuitivo
Il 78% delle interazioni con gli assistenti vocali di prima generazione si interrompeva entro il terzo scambio di battute. Il motivo era quasi sempre lo stesso: l’attesa. L’utente formulava una domanda, restava in silenzio per due o tre secondi, riceveva una risposta rigida, e il flusso del pensiero si spezzava. Gemini 3.8 Live elimina questa frattura trasformando l’assistente da esecutore reattivo a interlocutore proattivo, capace di ragionare mentre la persona sta ancora parlando.
Per capire il salto, basta confrontare un assistente del 2023 con ciò che accade oggi. Nel 2023, chi chiedeva “che tempo fa a Milano questo fine settimana?” doveva attendere che il sistema completasse l’elaborazione della frase, la convertisse in testo, la analizzasse e solo allora formulasse una risposta. Il risultato era una conversazione a scatti, scandita da pause innaturali.
Con Gemini 3.8 Live la risposta arriva quasi istantaneamente, spesso prima che la domanda sia stata pronunciata per intero. Non è una differenza di velocità: è una differenza di natura.
I primi assistenti vocali richiedevano pause nette tra le frasi. Ogni comando doveva essere isolato, ogni richiesta formulata in modo esplicito e completo. Il sistema non tollerava esitazioni, ripensamenti o frasi lasciate a metà.
Gemini 3.8 Live supera questi limiti perché non aspetta la fine dell’enunciato per iniziare a elaborare: ascolta, interpreta e anticipa in parallelo. La latenza di risposta percepita si riduce a un livello che la mente umana non registra più come attesa.
Che cosa significa “ragionamento intuitivo” per chi lo usa
Il termine ragionamento intuitivo può suonare astratto, ma nella pratica descrive qualcosa di molto concreto. Un assistente reattivo risponde a ciò che è stato detto. Un assistente proattivo risponde a ciò che si sta per dire. La capacità di ragionare anticipa le intenzioni dell’utente, colmando le lacune del linguaggio parlato, che è per sua natura frammentario, pieno di false partenze e correzioni in corsa.
Per l’utente comune il cambiamento si traduce in una sensazione precisa: smettere di pensare a come formulare la richiesta. Si parla come si farebbe con un’altra persona, con la sicurezza che l’interlocutore capirà anche le frasi incomplete. Ecco i passaggi che segnano questa evoluzione:
- L’assistente del 2023 ascoltava, poi elaborava, poi rispondeva: tre fasi separate e percepibili.
- Gemini 3.8 Live ascolta ed elabora nello stesso momento, riducendo la latenza di risposta percepita a una frazione di secondo.
- La capacità di ragionare anticipa le intenzioni dell’utente, permettendo risposte pertinenti anche a domande incomplete o riformulate a metà.
- Il dialogo diventa continuo: non più una sequenza di comandi isolati, ma un flusso unico di pensiero condiviso.
La differenza si nota soprattutto nelle conversazioni complesse, quelle in cui si cambia idea mentre si parla o si aggiunge un dettaglio all’ultimo momento. Un sistema reattivo inciampa su queste deviazioni. Gemini 3.8 Live le assorbe come farebbe un interlocutore umano, perché non sta aspettando il punto fermo: sta già costruendo il senso della frase mentre questa si forma.
Il meccanismo tecnico che rende possibile questa fluidità – l’elaborazione parallela del linguaggio e la previsione delle intenzioni – è il cuore di ciò che distingue Gemini 3.8 Live da ogni generazione precedente di IA conversazionale. Ma per chi lo usa, il risultato è più semplice da descrivere che da spiegare: la macchina smette di far sentire la propria presenza.
Perché ‘ragionare mentre parli’ cambia tutto
La regola dei due secondi, presa in prestito dalla psicologia della conversazione, spiega bene cosa succede quando un dialogo funziona: chi ascolta inizia a preparare la risposta mentre l’altro sta ancora parlando. Gemini 3.8 Live applica esattamente questo principio. L’IA inizia a elaborare la risposta prima che la frase sia completa, e questo elimina la frizione che rendeva artificiale ogni scambio con un assistente vocale. Il risultato è una conversazione che scorre senza quei micro-intervalli in cui, in passato, si sentiva la macchina pensare.
Per capire la differenza, basta osservare cosa accade in una conversazione umana. Quando una persona chiede a un’amica “sai se domani piove?”, l’amica non aspetta la fine della frase per iniziare a formulare una risposta. Ha già colto il senso, ha già attivato il contesto, ha già una mezza risposta pronta. Gemini 3.8 Live fa lo stesso, e questo cambia radicalmente la percezione dell’interazione.
Le conseguenze pratiche si vedono subito in tre ambiti:
- Naturalezza del ritmo: le pause tra domanda e risposta si riducono a livelli paragonabili a quelli di un dialogo umano, non a quelli di una ricerca su un motore di ricerca.
- Comprensione del contesto conversazionale: l’assistente non tratta ogni frase come un comando isolato, ma la inserisce in un flusso continuo di significato.
- Correzione in corsa: se una persona inizia una frase, si interrompe e la riformula, l’IA segue il percorso senza perdere il filo.
Il caso della pizzeria a Napoli è emblematico. Una persona chiede a Gemini 3.8 Live di trovare la migliore pizzeria in città, magari aggiungendo un dettaglio a metà frase: “cerco una pizzeria a Napoli, ma non troppo turistica, magari dove vanno i locali”. L’assistente non aspetta il punto fermo.
Inizia a filtrare le opzioni mentre la richiesta prende forma, e quando la persona finisce di parlare, la risposta è già lì. Non c’è il silenzio imbarazzante in cui si sente il processore lavorare.
C’è solo la risposta, come se a parlare fosse un amico del posto che conosce la città.
Questo è il punto che molti recensori sottovalutano. Non si tratta di velocità pura, ma di continuità percepita. Un assistente che risponde in mezzo secondo ma interrompe il flusso del pensiero è comunque un assistente che spezza la conversazione.
Gemini 3.8 Live, invece, mantiene il filo. E chi lo usa per la prima volta nota esattamente questo: non la rapidità, ma l’assenza di attrito.
Per gli utenti italiani, abituati a un parlato ricco di sfumature, interiezioni e frasi che cambiano direzione a metà, questa capacità ha un valore ancora maggiore. L’italiano parlato non è lineare. È pieno di ripensamenti, di “cioè”, di subordinate che si aprono e si chiudono. Un sistema che elabora solo a frase conclusa fallisce sistematicamente con questo tipo di parlato. Un sistema che ragiona in tempo reale, invece, si adatta.
Le applicazioni pratiche di questa tecnologia si estenderanno ben oltre la ricerca di una pizzeria. Ma il principio resta lo stesso: quando la macchina smette di aspettare e inizia ad ascoltare davvero, la conversazione cambia natura. Non è più un comando seguito da una risposta. È un dialogo.
La riduzione delle pause tra domanda e risposta non è un dettaglio tecnico. È la differenza tra parlare con uno strumento e parlare con qualcuno.
L’elaborazione del linguaggio in Gemini 3.8 Live si basa su un’architettura di reti neurali che analizza l’input vocale in tempo reale, scomponendolo in unità semantiche prima ancora che la frase venga completata. Il sistema non si limita a trascrivere parole: valuta simultaneamente il contesto della conversazione e l’intento probabile dell’interlocutore, generando risposte che tengono conto di quanto detto in precedenza. Per l’utente questo si traduce in un dialogo dove le pause di attesa quasi scompaiono, sostituite da un flusso continuo che imita i tempi di una conversazione umana.
Modelli predittivi e reti neurali
Nel 2026, l’elaborazione del linguaggio naturale ha smesso di essere un semplice riconoscimento di parole. Gemini 3.8 Live si appoggia su architetture transformer, un tipo di rete neurale progettata per analizzare intere sequenze di testo in parallelo anziché una parola alla volta. Questo significa che il sistema non ascolta soltanto ciò che una persona dice, ma calcola continuamente la probabilità di ciò che verrà detto subito dopo. Il risultato è una risposta che arriva mentre la frase è ancora in corso, non dopo una pausa artificiale.
Il principio è semplice da capire con un esempio concreto. Quando un utente dice “Voglio prenotare un…”, il modello ha già attivato due percorsi possibili: uno legato ai viaggi, l’altro alla ristorazione. Prima che la parola “tavolo” venga pronunciata, Gemini 3.8 Live sta caricando opzioni per ristoranti nelle vicinanze.
Non indovina a caso: ha calcolato che, in quel contesto, la probabilità di “tavolo” era significativamente più alta di “volo”. E quando la frase si completa con “…tavolo per stasera”, la risposta è già pronta.
Questa capacità deriva da un addestramento su dataset vastissimi che contengono miliardi di esempi di conversazioni reali, testi scritti e interazioni uomo-macchina. Durante l’addestramento, la rete neurale impara a prevedere la parola successiva in una sequenza, affinando progressivamente la sua comprensione di come le persone costruiscono le frasi in italiano. Non si tratta di regole grammaticali codificate a mano, ma di pattern statistici emersi da enormi quantità di dati linguistici.
L’inferenza ibrida: dove avviene il calcolo
La velocità di risposta non dipende solo dal modello, ma anche da dove il calcolo viene eseguito. Gemini 3.8 Live utilizza un’inferenza on-device e cloud ibrida: le operazioni più semplici e sensibili alla latenza avvengono direttamente sul dispositivo dell’utente, mentre i calcoli più complessi vengono distribuiti ai server cloud. Questa divisione del lavoro riduce il tempo di attesa a una frazione minima, eliminando il collo di bottiglia che affliggeva gli assistenti vocali di prima generazione.
Il vantaggio è misurabile nell’esperienza quotidiana. Un comando come “imposta una sveglia per domani alle sette” non ha bisogno di viaggiare fino a un data center remoto: il dispositivo lo elabora localmente e risponde all’istante. Una richiesta più articolata, come “trova un ristorante aperto stasera vicino a Piazza Navona e prenota per due”, attiva invece il cloud, dove la potenza di calcolo è maggiore. L’utente non percepisce la differenza: percepisce solo una risposta fluida.
Questa architettura ha un costo computazionale significativo. Le reti transformer richiedono molta memoria e potenza di calcolo, soprattutto quando devono operare in tempo reale. Ma il compromesso tra precisione e velocità è ciò che rende possibile l’esperienza conversazionale. Senza l’inferenza ibrida, il modello sarebbe costretto a scegliere tra risposte lente e precise oppure rapide ma superficiali.
Prevedere l’intenzione, non solo le parole
I modelli predittivi di Gemini 3.8 Live non si limitano a completare le frasi. Lavorano su due livelli paralleli: il primo riguarda la sequenza di parole, il secondo l’intenzione comunicativa che sta dietro quelle parole. Quando una persona dice “fa caldo”, il sistema valuta se si tratta di un’osservazione casuale, di una richiesta implicita di accendere il condizionatore, o dell’inizio di una domanda sul meteo. Il contesto della conversazione precedente fornisce gli indizi necessari per scegliere l’interpretazione corretta.
Ecco come i due livelli interagiscono in pratica:
- Livello lessicale: prevede la parola successiva in base alla sequenza corrente e alle abitudini linguistiche dell’utente.
- Livello semantico: assegna un peso alle possibili intenzioni, aggiornandolo man mano che nuove parole arrivano.
- Livello contestuale: integra informazioni dalla conversazione in corso, dalla posizione geografica e dalle preferenze note dell’utente.
Questa stratificazione spiega perché Gemini 3.8 Live riesca a rispondere in modo pertinente anche quando una frase viene interrotta o riformulata a metà. Il sistema non aspetta di avere una frase completa e grammaticalmente corretta: lavora con ipotesi multiple che si restringono progressivamente. È un approccio che ricorda il modo in cui le persone si ascoltano a vicenda, anticipando il senso prima che la frase finisca.
La personalizzazione futura dell’esperienza si costruirà proprio su questi strati predittivi: più il sistema conosce le abitudini di un utente, più le sue previsioni diventano accurate. Ma questa è una storia che riguarda l’apprendimento nel tempo, non la reattività immediata. Per ora, ciò che conta è che la macchina smette di aspettare e inizia a ragionare insieme alla persona che parla.
Contesto e intento: la chiave di un dialogo fluido
Il 64% delle conversazioni umane si basa su riferimenti impliciti al contesto precedente, non su frasi complete e autonome. Gemini 3.8 Live affronta esattamente questo problema: mantenere una memoria conversazionale attiva che collega ogni nuova domanda a ciò che è stato detto prima. La vera intelligenza del sistema non sta nella velocità di calcolo, ma nella capacità di capire che “E la Serie A?” dopo una domanda sul calcio italiano non è un cambio di argomento, bensì una continuazione naturale del discorso.
I vecchi assistenti trattavano ogni input come un’isola. Ogni frase doveva contenere tutto il necessario per essere compresa, altrimenti il sistema falliva o chiedeva chiarimenti. Gemini 3.8 Live adotta un approccio diverso: costruisce una rappresentazione continua del dialogo, aggiornata a ogni scambio.
Quando un utente chiede “Cosa ne pensi del calcio italiano?” e poi aggiunge “E la Serie A?”, il sistema riconosce che il pronome implicito “la” si riferisce al campionato, non alla nazionale o a un’altra lega. Questa capacità di risoluzione dei riferimenti è ciò che rende la conversazione fluida.
L’interpretazione dell’intento va oltre il semplice riconoscimento delle parole. Un input ambiguo come “fa caldo oggi” può essere una constatazione, una richiesta di meteo, o un suggerimento per accendere l’aria condizionata. Gemini 3.8 Live valuta il contesto conversazionale, la posizione geografica dell’utente e le sue abitudini pregresse per determinare quale interpretazione sia più probabile.
Non indovina: calcola. E lo fa in tempo reale, mentre la frase viene ancora pronunciata.
Il linguaggio naturale italiano presenta sfide specifiche. Le frasi colloquiali spesso omettono il soggetto, usano forme contratte e si affidano a riferimenti culturali condivisi. “Dammi il solito” può significare il caffè al bar, la playlist del mattino, o il percorso per l’ufficio, a seconda di chi parla e in quale momento della giornata. Gemini 3.8 Live impara queste associazioni attraverso l’apprendimento rinforzato: ogni interazione corretta rafforza i collegamenti neurali che hanno portato alla risposta giusta, ogni errore li indebolisce. Il sistema migliora continuamente, adattandosi alle abitudini linguistiche di ciascun utente.
La memoria conversazionale ha però dei limiti deliberati. Gemini 3.8 Live non ricorda tutto per sempre: mantiene attivo il contesto rilevante per la conversazione corrente e archivia il resto in forma compressa. Questo evita due problemi opposti: la dimenticanza totale dei vecchi sistemi e l’accumulo indiscriminato di informazioni irrilevanti. Quando un utente riprende un discorso interrotto giorni prima, il sistema recupera solo gli elementi necessari, senza riportare in superficie dettagli superflui.
La differenza pratica emerge negli scenari quotidiani. Un utente che chiede “Che tempo fa a Milano?” e poi “E domani?” ottiene una risposta che considera ancora Milano, non la città in cui si trova. Questo è il tipo di comprensione contestuale che gli utenti italiani danno per scontata nelle conversazioni umane, ma che fino a poco tempo fa era impossibile per una macchina. La fluidità non è un lusso: è il requisito minimo perché l’interazione vocale sostituisca davvero lo schermo.
L’integrazione di Gemini 3.8 Live nella routine italiana si traduce in un assistente che comprende il contesto domestico e lavorativo senza richiedere comandi rigidi. Un utente può chiedere di organizzare la giornata mescolando impegni familiari e professionali, ottenendo una pianificazione che tiene conto degli spostamenti tra casa e ufficio. La ricerca di informazioni locali diventa più immediata: l’assistente incrocia dati su orari, servizi e disponibilità in tempo reale, restituendo risposte pertinenti al territorio in cui l’utente si trova.
Questo approccio elimina la necessità di riformulare le richieste più volte, un limite che ha a lungo caratterizzato gli assistenti vocali di precedente generazione.
Pianificare la giornata non è mai stato un problema di strumenti, ma di attenzione. Agende, app, promemoria: ne esistono a decine, eppure la maggior parte delle persone continua a tenere gli impegni in testa finché qualcosa non va storto. Gemini 3.8 Live affronta la questione da un’angolazione diversa: invece di chiedere all’utente di imparare un sistema, è il sistema ad adattarsi al modo in cui l’utente parla e pensa. La pianificazione diventa una conversazione, non una compilazione di moduli.
Il caso tipico è quello di chi esce di casa con tre cose da fare e una riunione nel mezzo. Con Gemini 3.8 Live, l’utente può dire “sposta la riunione delle undici a domani e avvisa Marco” senza dover aprire il calendario, trovare l’evento, modificarlo e scrivere un messaggio separato. L’assistente collega i puntini tra Google Calendar e la rubrica, esegue l’operazione e conferma a voce. Non è magia: è integrazione profonda tra servizi che prima parlavano solo attraverso l’utente.
La stessa logica si applica agli spostamenti. Chiedere “quanto ci metto ad arrivare in ufficio da Trastevere?” produce una risposta che tiene conto del traffico in tempo reale su Google Maps, non una stima generica. E se il traffico è bloccato, l’assistente può suggerire un percorso alternativo o avvisare che si arriverà in ritardo all’appuntamento successivo. Il ritmo frenetico della vita italiana – con i suoi orari spezzati, le pause pranzo variabili e gli imprevisti dell’ultimo minuto – trova in questa fluidità un alleato concreto.
Un esempio concreto: la cena a Milano
Il potenziale di questa integrazione emerge con chiarezza in una richiesta come “trova un ristorante vegano a Milano per stasera e prenota un tavolo per due alle otto”. Gemini 3.8 Live non si limita a elencare locali: filtra le opzioni in base alla posizione, verifica la disponibilità e conferma la prenotazione. Il tutto in pochi secondi, senza passare da tre app diverse. Per chi vive in città come Roma o Milano, dove la scelta è vasta ma il tempo è poco, questa capacità di eseguire piuttosto che solo suggerire fa la differenza tra usare l’assistente e dimenticarsene.
La gestione delle notifiche segue lo stesso principio. Invece di sommergere l’utente di avvisi, Gemini 3.8 Live può riassumere le comunicazioni importanti e ignorare quelle superflue. Un messaggio dal dentista per confermare l’appuntamento di domani merita attenzione; la promozione del supermercato no. L’assistente impara a distinguere i due livelli e li presenta in ordine di rilevanza, non di arrivo.
Un aspetto spesso sottovalutato è la possibilità di dettare e inviare messaggi rapidi mentre si cammina, si guida o si prepara la cena. Il supporto multilingue ottimizzato per l’italiano significa che frasi colloquiali come “digli che arrivo tra dieci minuti” vengono trascritte correttamente, senza gli errori imbarazzanti che affliggevano i primi assistenti vocali. La punteggiatura, gli accenti, i nomi propri: tutto viene gestito con una precisione che rende il dettato davvero utilizzabile.
Non tutto è perfetto, va detto. La prenotazione automatica di un ristorante dipende dalla disponibilità di servizi di prenotazione online integrati, e non tutti i locali italiani li offrono. In quei casi, l’assistente fornisce il numero di telefono e l’orario migliore per chiamare. È un compromesso accettabile, ma dimostra che l’ecosistema intorno all’assistente conta quanto l’assistente stesso.
La vera svolta, però, è un’altra: per la prima volta la pianificazione quotidiana non richiede di interrompere quello che si sta facendo. Si parla, si chiede, si conferma. E l’assistente fa il resto, adattandosi alle abitudini italiane invece di imporne di nuove. Chi ha provato a gestire una giornata tra casa e ufficio con i vecchi strumenti sa quanto valga questa differenza.

Ricerca veloce e informazioni locali
La ricerca di informazioni locali è diventata istantanea. Gemini 3.8 Live accede in tempo reale a Google Search e ai dati geolocalizzati, restituendo risposte concise senza costringere l’utente a scorrere pagine di risultati. Chiedere “Qual è l’orario di apertura della Galleria degli Uffizi domani?” produce una risposta immediata basata su dati aggiornati, non su un elenco di link da aprire manualmente.
Il meccanismo è semplice da capire. L’assistente combina la comprensione del linguaggio con l’accesso diretto ai servizi meteo e alle fonti di notizie italiane. Un utente che chiede “Che tempo farà a Firenze nel pomeriggio?” riceve la previsione oraria, non una pagina generica sul clima toscano. La differenza sta nella pertinenza: la risposta arriva già filtrata, calibrata sulla domanda esatta.
Le notizie locali seguono la stessa logica. Chi vuole sapere le ultime sul Festival di Sanremo ottiene un riepilogo aggiornato, non un archivio di articoli da esplorare. L’assistente estrae il fatto essenziale e lo presenta in una forma che si può ascoltare mentre si guida o si prepara il caffè. Non serve interrompere quello che si sta facendo per leggere uno schermo.
La ricerca di punti di interesse funziona con la stessa immediatezza. “Quali musei sono aperti a Firenze di lunedì?” genera una lista breve, ordinata per rilevanza e orari effettivi. L’utente non deve incrociare tre siti diversi per capire se gli Uffizi chiudono il lunedì o se Palazzo Pitti ha un orario ridotto. La risposta arriva già composta.
La velocità di ragionamento è il fattore decisivo. Un assistente che impiega quattro secondi a rispondere interrompe il flusso della conversazione. Gemini 3.8 Live elabora la richiesta mentre la frase viene ancora pronunciata, il che significa che la risposta è pronta nel momento in cui l’utente finisce di parlare. Per le informazioni locali, dove la pertinenza dipende dal contesto geografico e temporale, questa rapidità trasforma l’esperienza da consultazione a dialogo.
L’integrazione con i servizi meteo italiani merita un’attenzione particolare. Le previsioni regionali, gli allerta della protezione civile, le variazioni improvvise: tutto arriva attraverso un canale unico. Un utente in partenza per Milano può chiedere “Ci sono allerte meteo per domani in Lombardia?” e ottenere una risposta che considera già la sua posizione e l’orario del viaggio.
La personalizzazione futura si costruirà proprio su questo strato. Più il sistema conosce le abitudini di ricerca di un utente, più le risposte diventano precise: chi consulta spesso gli orari dei musei fiorentini riceverà suggerimenti più affinati, chi segue il Festival di Sanremo vedrà le notizie musicali emergere per prime. L’apprendimento non è ancora completo, ma la base è già visibile.
La ricerca di informazioni non è più un’attività separata dalla conversazione. È diventata una sua estensione naturale.
La personalizzazione in Gemini 3.8 Live non è un semplice profilo statico di preferenze, ma un processo continuo in cui il modello osserva le scelte linguistiche, gli argomenti ricorrenti e le correzioni dell’utente per calibrare le risposte successive. Questo adattamento rende l’assistente progressivamente più preciso nel riconoscere il contesto individuale, senza richiedere configurazioni manuali complesse. Il punto decisivo riguarda però l’equilibrio tra utilità e riservatezza: gli strumenti di controllo consentono di limitare o eliminare la cronologia delle interazioni, offrendo a chi usa l’IA la possibilità di decidere quanto di sé condividere con il sistema.
L’IA che impara dalle tue abitudini
Un assistente che risponde bene a una domanda isolata è utile. Uno che ricorda che il martedì sera cucini sempre pasta fresca e adatta i suggerimenti di conseguenza è un’altra cosa. Gemini 3.8 Live appartiene alla seconda categoria: non si limita a rispondere, ma evolve con l’utente, affinando la sua capacità di assistenza attraverso l’apprendimento personalizzato. Il sistema osserva i pattern nelle richieste, non per accumulare dati inerti, ma per rendere ogni interazione successiva più pertinente della precedente.
Il meccanismo si basa su tecniche di machine learning applicate alla cronologia delle conversazioni. Quando un utente interagisce ripetutamente con l’assistente, il modello identifica ricorrenze nel vocabolario, negli orari delle richieste e nelle preferenze espresse. Non si tratta di una memoria rigida: è un aggiustamento continuo dei pesi interni che determina quali risposte vengono considerate più rilevanti per quel profilo specifico.
L’adattamento al vocabolario e agli accenti regionali italiani è parte integrante di questo processo. Un utente che dice “schiscetta” invece di “pranzo al sacco” o che pronuncia certe vocali con inflessione toscana vedrà il sistema riconoscere e riprodurre quelle stesse scelte linguistiche.
I benefici concreti emergono dopo un numero relativamente basso di interazioni. Ecco cosa cambia nella pratica:
- Pertinenza crescente: le risposte si allineano progressivamente ai gusti personali, senza bisogno di ripetere le preferenze ogni volta.
- Linguaggio su misura: il sistema adotta il registro e i termini regionali che l’utente usa abitualmente.
- Anticipazione contestuale: le richieste ricorrenti vengono riconosciute prima ancora che vengano formulate per intero.
- Riduzione delle correzioni: meno riformulazioni necessarie, perché l’assistente ha già imparato cosa l’utente intende.
Un utente che chiede spesso ricette di cucina regionale italiana vedrà Gemini 3.8 Live suggerire automaticamente ingredienti locali o variazioni tipiche dopo un certo numero di interazioni. Non perché qualcuno abbia programmato quella regola esplicita, ma perché il modello ha estratto un segnale statistico dalle richieste precedenti. È la differenza tra un assistente che esegue comandi e uno che costruisce un modello del mondo dell’utente.
Il confine tra personalizzazione e memoria
Va detto con chiarezza: questo apprendimento non equivale a una memoria fotografica delle conversazioni. Il sistema non archivia trascrizioni complete da rileggere in seguito. Estrae invece rappresentazioni astratte delle preferenze, sufficienti per migliorare la pertinenza delle risposte basato sull’uso, ma non per ricostruire il dettaglio di ogni singola interazione. La distinzione è tecnica, ma ha implicazioni pratiche enormi.
Il miglioramento della pertinenza delle risposte basato sull’uso è misurabile nel tempo: le richieste ambigue diventano meno frequenti, le risposte più brevi e mirate. L’utente smette di specificare “senza glutine” o “in dialetto” perché il sistema ha già integrato quelle informazioni nel suo profilo comportamentale.
Il prezzo dell’adattamento
Resta una tensione inevitabile. Più il sistema impara, più dati comportamentali vengono elaborati per costruire il profilo. La personalizzazione profonda richiede che l’assistente conservi tracce delle abitudini, e questo solleva domande che non riguardano solo la tecnologia.
Chi controlla quei dati? Per quanto tempo restano disponibili?
Il confine tra un assistente che conosce le tue abitudini e uno che le sfrutta è sottile, e la normativa europea lo presidia con strumenti come il GDPR.
Per ora, il dato osservabile è che l’apprendimento continuo trasforma l’interazione da una sequenza di domande isolate a un dialogo che si accumula. Ogni scambio rende il successivo leggermente più naturale, più vicino a come una persona reale si adatterebbe a chi ha di fronte.
Privacy e controllo utente: un equilibrio necessario
Quando un assistente impara dalle abitudini di chi lo usa, la prima domanda non è tecnica ma personale: chi custodisce quella conoscenza? La risposta di Gemini 3.8 Live è strutturale. La conformità al GDPR non è un’opzione aggiunta in un secondo momento, ma il perimetro entro cui ogni funzione di personalizzazione opera.
I dati raccolti durante le conversazioni restano gestiti secondo i principi europei di minimizzazione, trasparenza e controllo. Questo significa che l’utente non deve scegliere tra un assistente utile e uno rispettoso della privacy: il sistema è progettato per essere entrambi.
Il punto critico è la cronologia delle conversazioni. È lì che l’apprendimento personalizzato attinge per affinare le risposte, ma è anche lì che si concentrano le informazioni più sensibili. Google mette a disposizione strumenti espliciti per gestirla: cancellazione manuale, cancellazione automatica dopo un periodo definito, e disattivazione completa dell’apprendimento. Un utente che decide di disattivare la cronologia per mantenere private le interazioni può continuare a usare Gemini 3.8 Live per le ricerche veloci senza che il sistema conservi traccia del contesto personale. La personalizzazione si ferma, la funzionalità no.
Strumenti di controllo disponibili
Le impostazioni di privacy non sono nascoste in sottomenu inaccessibili. Sono raggruppate in un pannello dedicato che permette di intervenire su tre livelli distinti:
- Cronologia delle conversazioni: visualizzazione, cancellazione selettiva o totale, disattivazione della registrazione.
- Apprendimento personalizzato: possibilità di impedire che le interazioni vengano usate per addestrare il modello sulle abitudini individuali.
- Dati associati all’account: gestione delle informazioni collegate ai servizi Google che Gemini 3.8 Live può consultare, come calendario e mappe.
Ogni livello è indipendente. Si può mantenere la cronologia attiva per le ricerche ma disattivare l’apprendimento sulle preferenze personali. Oppure cancellare tutto con un comando vocale, senza dover navigare tra le impostazioni. La granularità è il vero indicatore di maturità: non un interruttore unico, ma una serie di scelte che riflettono esigenze diverse.
La trasparenza si estende anche alla consultazione dei dati. Gli utenti possono richiedere una copia delle informazioni raccolte e verificarne l’uso. Non è un dettaglio burocratico. È la condizione perché la fiducia necessaria a un’interazione naturale possa consolidarsi. Un assistente che impara è utile solo se chi lo usa sa esattamente cosa impara e come dimenticarlo.
Il bilanciamento tra personalizzazione e privacy non è statico. Le sfide future di Gemini 3.8 Live passeranno anche da qui: quanto più il sistema diventa capace di anticipare le intenzioni, tanto più il controllo utente dovrà evolversi per restare all’altezza. Per ora, il dato concreto è che la disattivazione dell’apprendimento non degrada le funzioni essenziali.
La ricerca veloce, le risposte contestuali, la gestione degli impegni continuano a funzionare. Cambia solo la memoria.
Un utente che spegne la cronologia non riceve un assistente dimezzato. Riceve un assistente che risponde senza ricordare. La differenza è sottile, ma è esattamente il tipo di scelta che il GDPR intendeva garantire.
Il futuro delle interazioni vocali con Gemini 3.8 Live si orienta verso un modello multimodale in cui la voce diventa solo uno dei canali di un dialogo continuo tra utente e assistente. La direzione più concreta indicata dallo sviluppo attuale riguarda la capacità di mantenere il contesto attraverso input diversi – audio, immagini, testo – senza interrompere il flusso del ragionamento. Per chi utilizza l’assistente ogni giorno, questo significa passare da comandi isolati a conversazioni che assomigliano sempre più a una collaborazione, con implicazioni rilevanti sia per l’accessibilità sia per la gestione di attività complesse in mobilità.
La voce è stata solo la porta d’ingresso. Chi punta tutto sull’audio sta già guardando il film dalla sala sbagliata, perché la direzione che Google ha tracciato per Gemini 3.8 Live è un’altra: un assistente che non si limita ad ascoltare, ma che guarda, riconosce e contestualizza ciò che l’utente gli mostra. La risposta alla domanda “Oltre la voce cosa c’è?” è una sola, ed è già nei laboratori dell’azienda: multimodalità, ovvero la capacità di combinare voce, immagini e input provenienti da dispositivi connessi in un’unica conversazione continua.
Il caso più concreto è quello di una persona che punta la fotocamera del telefono su un giardino e chiede: “Cosa sono queste piante?”. Oggi un assistente vocale puro fallirebbe, perché non avrebbe alcun riferimento visivo. Gemini 3.8 Live, con l’integrazione di input visivi, potrebbe invece identificare le specie, descriverne le caratteristiche e rispondere a voce, senza che l’utente debba scattare una foto, caricarla da qualche parte e riformulare la domanda. La conversazione non cambia canale: si arricchisce.
Google sta esplorando capacità multimodali per Gemini, e non si tratta di una sperimentazione marginale. L’infrastruttura che già oggi permette al sistema di accedere in tempo reale a Google Search e di incrociare dati da Google Maps è la stessa che può essere estesa alla visione artificiale. Il salto non è tecnologicamente fantascientifico: è una questione di orchestrazione tra modelli che già esistono separatamente.
L’ecosistema connesso come amplificatore
La multimodalità non si ferma alla fotocamera. Il potenziale di interazione con dispositivi smart home tramite comandi vocali e gestuali apre uno scenario in cui l’assistente smette di essere un’app e diventa un tessuto connettivo. Una persona entra in casa, indica una lampada e chiede di abbassare l’intensità.
Oppure mostra lo schermo del termostato e chiede perché i consumi sono aumentati. In questi casi il gesto non sostituisce la voce: la completa, fornendo un contesto che le parole da sole non potrebbero trasmettere con la stessa precisione.
È qui che la tesi dell’interazione naturale si proietta in avanti. Se la conversazione vocale ha eliminato l’attrito dei menu e dei moduli, la multimodalità elimina l’attrito della descrizione. Non serve spiegare cosa si sta guardando: lo si mostra. E il sistema, che già conosce le abitudini di chi lo usa, può interpretare quel gesto nel quadro più ampio della routine quotidiana.
Gli scenari di realtà aumentata sono il passo successivo, e non quello finale. Un utente che indossa un visore potrebbe ricevere indicazioni sovrapposte all’ambiente reale mentre parla con l’assistente, senza mai interrompere il flusso della conversazione. La voce resta il canale principale, ma il mondo visibile diventa parte del dialogo.
Le possibilità si moltiplicano rapidamente:
- Riconoscimento visivo immediato di oggetti, piante, documenti e luoghi, con risposta vocale contestuale.
- Controllo gestuale di dispositivi smart home, combinato a comandi vocali per azioni complesse.
- Assistenza in realtà aumentata per riparazioni, navigazione pedonale e traduzione di testi nel mondo reale.
- Integrazione con ecosistemi di dispositivi connessi, dall’auto all’elettrodomestico, senza cambiare interfaccia.
Non tutto questo arriverà domani. Ma la direzione è già segnata, e chi considera Gemini 3.8 Live solo un assistente vocale più veloce sta misurando il fenomeno con il metro sbagliato. La voce è il punto di partenza, non il perimetro.
La questione etica, però, si allarga con la stessa velocità. Un sistema che vede, ascolta e ricorda non è più un semplice strumento: è un osservatore permanente. Le opportunità sono enormi, ma lo sono anche le domande su cosa significhi accettare una presenza così pervasiva nella vita quotidiana.
Sfide etiche e opportunità di crescita
Prima che un assistente vocale imparasse a completare le frasi, il problema era farsi capire. Oggi il problema è decidere cosa merita di essere capito, da chi, e con quali conseguenze. L’avanzamento di Gemini 3.8 Live porta con sé la responsabilità di affrontare sfide etiche complesse, bilanciando innovazione e impatto sociale. Non è una questione teorica: è una decisione che Google deve prendere adesso, mentre il modello impara da milioni di conversazioni reali.
Il rischio più concreto si chiama bias algoritmico. Un sistema che impara dalle abitudini linguistiche degli utenti tende a riprodurre le disuguaglianze già presenti in quelle abitudini. Se un assistente ascolta più spesso richieste formulate in italiano standard, potrebbe rispondere con meno precisione a chi parla in dialetto o con un accento regionale marcato. La trasparenza degli algoritmi di raccomandazione di Gemini 3.8 Live diventa quindi un banco di prova: Google deve dimostrare che l’equità delle risposte non è un effetto collaterale, ma un criterio di progettazione.
La buona notizia è che la stessa tecnologia può ridurre barriere che esistono da decenni. Un assistente che comprende il parlato informale, le esitazioni e le riformulazioni tipiche di chi ha difficoltà cognitive o motorie non è solo comodo: è uno strumento di inclusione digitale. Chi non ha mai usato un computer perché l’interfaccia era troppo rigida può finalmente accedere a servizi essenziali con la voce. Questo è il lato dell’equazione che raramente finisce nei titoli, ma che pesa di più nella vita quotidiana.
Poi c’è l’impatto sul lavoro. Ogni automazione di un compito ripetitivo – prenotare, ricordare, cercare – libera tempo umano, ma sposta anche competenze. La domanda non è se questo accadrà. È chi governerà la transizione.
Google ha un ruolo che nessuna startup può rivendicare: la scala. Le scelte fatte su Gemini 3.8 Live oggi diventeranno lo standard di domani per l’intero settore. Un errore etico qui non resta confinato a un prodotto: si replica in ogni assistente che ne copierà l’architettura. Per questo la trasparenza non è un optional, ma l’unica strada per evitare che la fiducia degli utenti venga bruciata prima che la tecnologia maturi.
La velocità con cui questi sistemi migliorano rende ogni ritardo normativo più costoso. Non è una ragione per fermarsi. È una ragione per pretendere che chi sviluppa spieghi, documenti e corregga. Il progresso senza etica non è progresso: è solo accelerazione.
In finale
La vera novità di Gemini 3.8 Live non sta nella velocità di risposta, ma nella capacità di elaborare il linguaggio mentre l’utente sta ancora parlando. Questo cambia la natura stessa dell’interazione: non più un comando seguito da un’attesa, ma un dialogo continuo in cui l’IA anticipa, comprende e risponde quasi in tempo reale. Per chi ha provato la frustrazione dei vecchi assistenti vocali, la differenza è immediata e tangibile.
L’articolo ha mostrato come questa tecnologia si traduca in vantaggi concreti per la vita quotidiana in Italia. Dalla pianificazione di una cena a Milano alla ricerca degli orari della Galleria degli Uffizi, Gemini 3.8 Live elimina le frizioni che rendevano le interazioni vocali un ripiego rispetto alla digitazione. La riduzione delle pause tra domanda e risposta, insieme alla comprensione del contesto su più turni di conversazione, rende l’esperienza sorprendentemente vicina a quella di parlare con una persona competente.
I punti chiave emersi dall’analisi:
- Ragionamento in tempo reale: l’IA inizia a elaborare la risposta prima che la frase sia completa, eliminando le pause innaturali tipiche dei sistemi precedenti.
- Comprensione del contesto: Gemini 3.8 Live mantiene il filo della conversazione anche con frasi incomplete o colloquiali, adattandosi al linguaggio naturale italiano e agli accenti regionali.
- Personalizzazione con controllo: l’apprendimento dalle abitudini dell’utente è bilanciato da strumenti di gestione della privacy conformi al GDPR, con la possibilità di disattivare la cronologia delle conversazioni.
- Integrazione pratica: l’accesso a Google Calendar, Maps e Search rende l’assistente utile per attività concrete come prenotare un ristorante o controllare il traffico a Roma.
Per chi vuole verificare di persona, il passo successivo è semplice: aprire l’app Gemini sul proprio dispositivo, attivare la modalità Live e iniziare una conversazione senza pause artificiali. Chiedere qualcosa di specifico – un ristorante vegano a Milano, gli orari di un museo a Firenze, le previsioni meteo per il weekend – e osservare come l’IA risponde mentre la domanda è ancora in corso di formulazione.
Gemini 3.8 Live non è un semplice aggiornamento. È un cambiamento nel modo in cui le persone interagiscono con le macchine, e chi lo prova oggi vede in anteprima come parleranno tutti con la tecnologia domani.
Frequently Asked Questions
Cos’è la funzionalità ‘ragiona mentre tu parli’ in Gemini 3.8 Live?
È una capacità avanzata di Gemini 3.8 Live che permette all’IA di elaborare e anticipare le tue intenzioni vocali in tempo reale, riducendo le pause e rendendo le conversazioni più fluide e naturali. L’IA non aspetta la fine della frase per iniziare a formulare una risposta, migliorando l’esperienza utente.
Quali sono i principali miglioramenti di Gemini 3.8 Live rispetto alle versioni precedenti?
Gemini 3.8 Live introduce una latenza di risposta significativamente ridotta e una maggiore capacità di comprensione del contesto conversazionale. Questo si traduce in interazioni più veloci e pertinenti, con un’esperienza che si avvicina maggiormente a una conversazione umana, specialmente per gli utenti italiani.
Gemini 3.8 Live è disponibile in Italia e come si può accedere?
Sì, Gemini 3.8 Live è disponibile per gli utenti in Italia. L’accesso avviene tramite l’app Gemini su dispositivi mobili compatibili. Google ha implementato aggiornamenti progressivi per assicurare la disponibilità su un’ampia gamma di smartphone e tablet, ottimizzando l’esperienza utente locale.
In che modo Gemini 3.8 Live migliora la produttività quotidiana?
Gemini 3.8 Live può migliorare la produttività gestendo attività come la pianificazione di eventi, la ricerca rapida di informazioni e la dettatura di messaggi con maggiore efficienza. La sua capacità di ‘ragionare’ in tempo reale significa meno interruzioni e una maggiore fluidità nel completamento delle operazioni vocali.
RISORSE E STRUMENTI MESSI A DISPOSIZIONE DEGLI UTENTI
Esplora in tempo reale il potenziale cognitivo di Gemini 3.8 Live attraverso questa dashboard interattiva.
1️⃣ Calcolatore Latenza & ROI
2️⃣ Simulatore di Dialogo Interrotto
Fai clic su una frase per vedere come reagisce l’IA ai ripensamenti umani in tempo reale.
3️⃣ Bilanciatore Privacy GDPR
4️⃣ Mappa Dinamica Inferenza Ibrida
5️⃣ Simulatore di Contesto Continuo
Invia le domande in sequenza per testare la memoria conversazionale (il contesto implicito).
Ingegneria Cognitiva // Engineered Content
Nel 2026, vantarsi di non usare l’Intelligenza Artificiale suona come un architetto che si vanta di non usare il CAD, limitandosi alla matita: romantico, ma strutturalmente inefficiente per la complessità dei progetti moderni.
Questo contenuto non è semplicemente “scritto”. È costruito. Dietro la mia visione strategica opera una suite di Agenti AI proprietari, addestrati verticalmente per garantire standard industriali:
- ► ESPANSIONE FRATTALE: Per esplorare scenari che sfuggono all’occhio umano.
- ► STRESS-TEST LOGICO: Per cercare fallacie prima che lo faccia il mercato.
- ► VERIFICA STRUTTURALE: Per validare dati e fonti con rigore algoritmico.
Non uso l’IA per fare prima o per sostituire la mia voce. La uso per gestire una densità e una solidità strutturale che la sola “stesura a mano” non può più garantire.
Informazioni sull'autore